בכל צוות כספים שנכנסתי אליו השנה היה קובץ אחד שכולם יודעים שהוא כבד.
והפתרון תמיד זהה. מישהו העביר את החישוב למצב ידני, וכולם למדו ללחוץ על מקש החישוב לפני שמסתכלים על המספר.
זה עובד. וזו בדיוק הבעיה.
כי קובץ שעבר לחישוב ידני אינו קובץ מהיר. הוא קובץ שמציג מספר ישן עד שמישהו יזכור ללחוץ. ובדוח שנשלח להנהלה, זה ההבדל בין איחור לבין טעות.
מה שהתיעוד אומר ואף אחד לא קורא
מיקרוסופט מתעדת את זה בגלוי, בעמוד על ביצועי חישוב.
חישוב שנמשך פחות מעשירית שנייה נחווה כמיידי. בין עשירית שנייה לשנייה שלמה המשתמש שם לב להשהיה אבל שומר על רצף מחשבה. בין שנייה לעשר שניות הוא נאלץ לעבור לחישוב ידני, ורמת הטעויות והתסכול מתחילה לעלות. מעל עשר שניות הוא פשוט עובר למשימה אחרת בזמן שהקובץ מחשב.
ושם מופיע המשפט החשוב באמת. חישוב איטי ופעולות איטיות כמו מיון וסינון מקשים על ריכוז, וחוסר ריכוז מגדיל טעויות.
כלומר, קובץ אקסל איטי אינו בעיית נוחות. הוא גורם סיכון לאיכות העבודה. וזה לא אני אומר את זה, זה כתוב אצל היצרן.
למי שמנהל דוח שנחתם ונשלח, ההבחנה הזו משנה את סדר העדיפויות. הקובץ הכבד יורד מרשימת המטלות המעצבנות ועולה לרשימת הסיכונים.
הסיבה שלא רואים בנתונים
עכשיו לחלק שמפתיע.
ההנחה הרווחת היא שקובץ איטי הוא קובץ גדול. יותר מדי שורות, יותר מדי גיליונות, יותר מדי נוסחאות. ולכן הפתרון הראשון שכולם מנסים הוא לפצל את הקובץ לשניים.
באותו עמוד תיעוד מיקרוסופט כותבת את ההפך. לא מספר הנוסחאות ולא גודל הקובץ צורכים את זמן החישוב, אלא מספר ההפניות לתאים, מספר פעולות החישוב, והיעילות של הפונקציות שבשימוש.
זה משנה הכל. פיצול קובץ שלא נגע במספר ההפניות מייצר שני קבצים איטיים במקום אחד, ומוסיף קישורים חיצוניים שמוסיפים בעיה משלהם.
יש שלוש סיבות אמיתיות, וכולן בלתי נראות מהנתונים עצמם.
סיבה ראשונה, פונקציות נדיפות
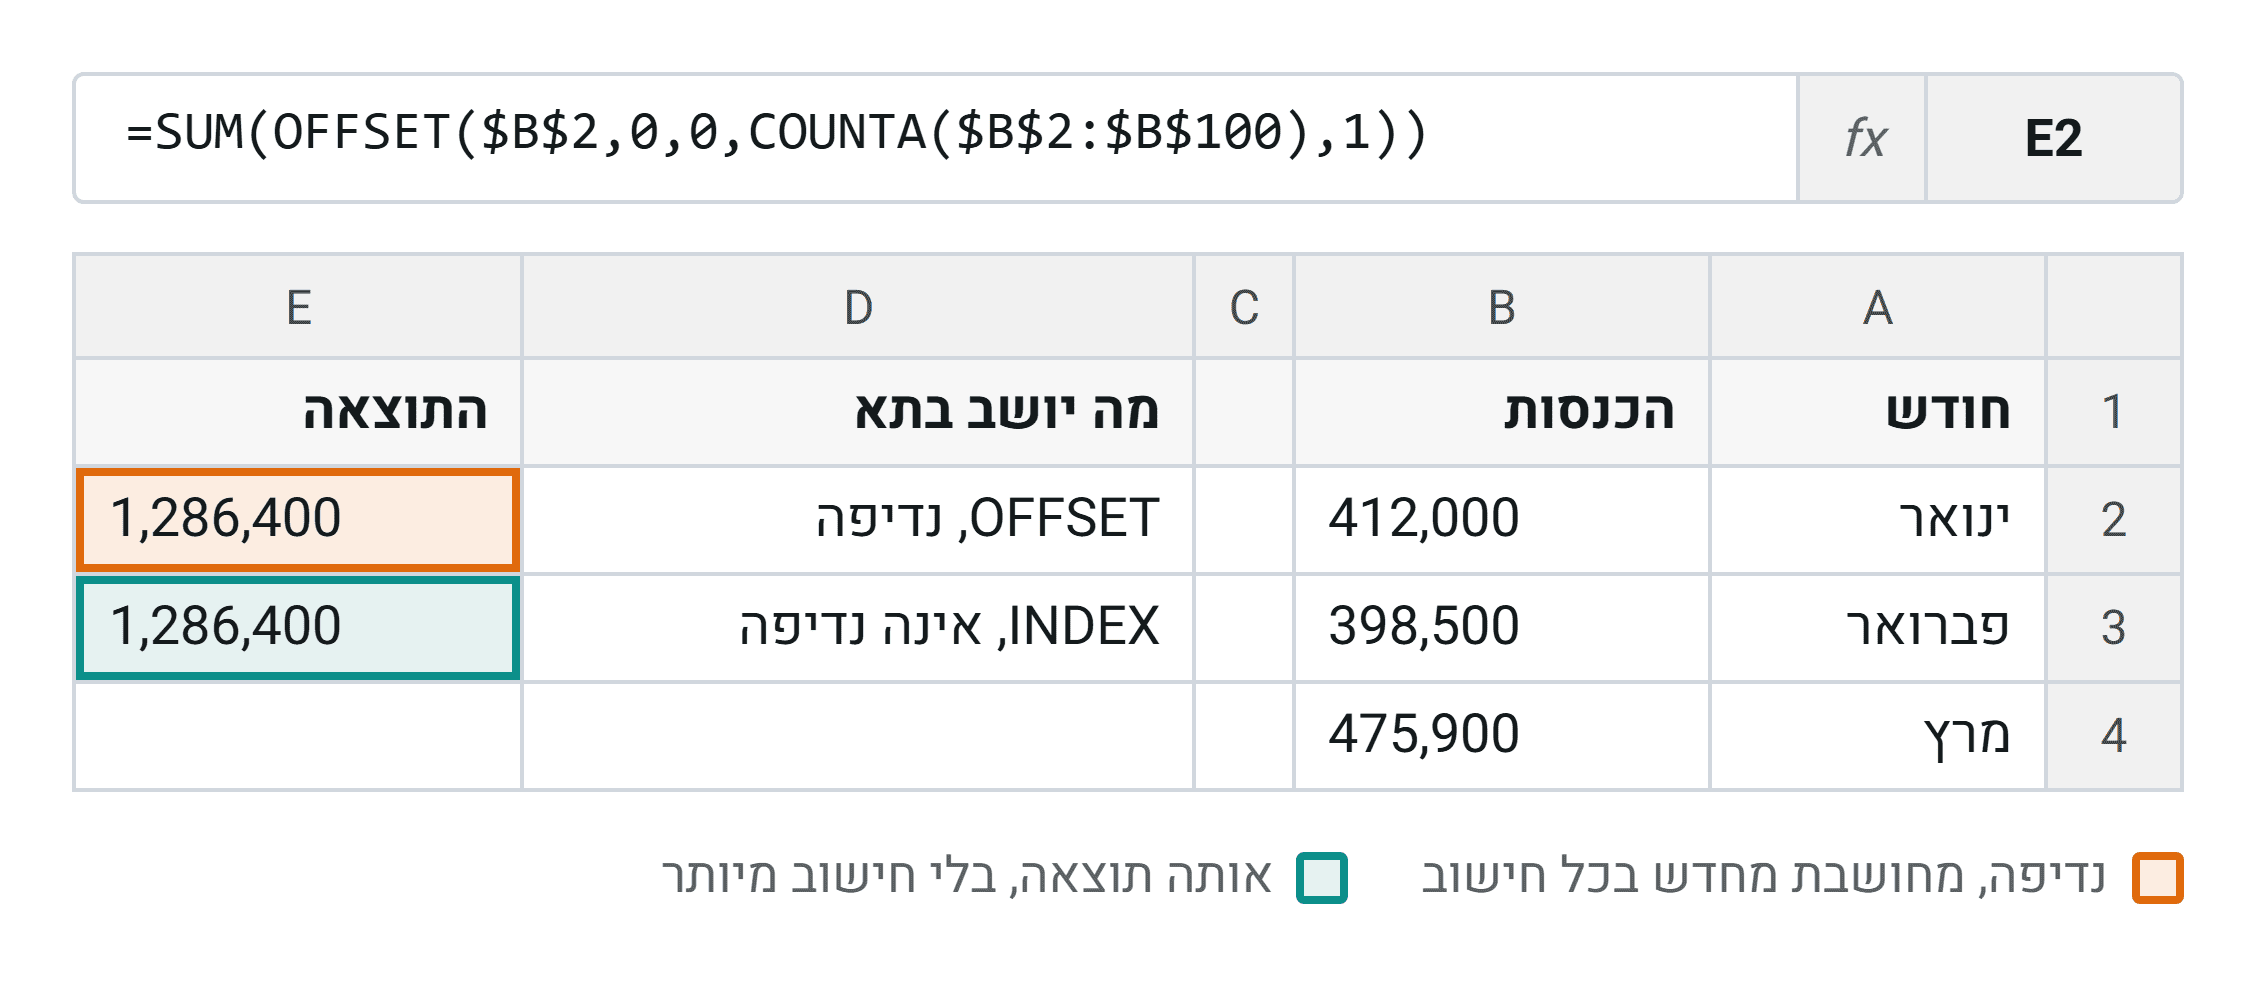
פונקציה נדיפה מחושבת מחדש בכל חישוב, גם כשאף אחד מהקלטים שלה לא השתנה.
הברורות הן RAND, NOW ו-TODAY. הפחות ברורות, ואלה שמופיעות בכל קובץ כספי, הן INDIRECT, OFFSET, CELL ו-INFO. הפונקציה INDIRECT היא גם אחת מהפונקציות שרצות על מעבד יחיד בלבד, כלומר היא לא נהנית מריבוי הליבות שבמחשב שלכם.
וכאן החלק שהופך את זה למעניין. באותו סעיף מיקרוסופט מציינת במפורש שארבע פונקציות תועדו בעבר כנדיפות ואינן נדיפות בפועל. הפונקציות INDEX, ROWS, COLUMNS ו-AREAS.
הרבה אנשים ראו פעם מדריך שאמר להיזהר מהן, והם נזהרים עד היום מהפונקציות הלא נכונות.
סיבה שנייה, פעולות שמפעילות חישוב
זו הסיבה שהכי קשה לאתר, כי היא לא נמצאת באף נוסחה.
מיקרוסופט מפרטת רשימה של פעולות שמפעילות חישוב מחדש בכל הקבצים הפתוחים. סינון. הסתרת שורות. ביטול הסתרה של שורות. הוספה או מחיקה של שורות, עמודות ותאים. הוספה, שינוי או מחיקה של שמות מוגדרים. שינוי שם של גיליון או הזזתו.
עכשיו תחשבו מה בדיוק עושה בקר בסגירת חודש. הוא מסנן. הוא מסתיר שורות. הוא מוסיף שורה. הוא מסנן שוב.
כל פעולה כזו מפעילה חישוב מחדש של כל הקבצים הפתוחים, גם אלה שאין להם קשר לעבודה הנוכחית.
ולזה מצטרף עיצוב מותנה. מיקרוסופט כותבת שכל נוסחת עיצוב מותנה בתא שמוצג על המסך מחושבת בכל חישוב וגם בכל פעם שהתצוגה של התא מתרעננת. בקובץ שעברו עליו חמש שנים של שכבות עיצוב שהועתקו והודבקו, זה מצטבר.
יש גם מקרה מיוחד ששווה להכיר. טבלאות נתונים, אלה שמתחת לניתוח מה אם, מבצעות חישוב חוזר של כל הקובץ לכל צירוף ערכים, והחישוב הזה תמיד רץ על מעבד יחיד. אותו דבר נכון להפניות מעגליות שנפתרות באיטרציות.
סיבה שלישית, המבנה
זו הסיבה עם המספרים הברורים ביותר, והם מגיעים מדוגמה שמיקרוסופט עצמה מפרסמת.
המשימה היא לספור ערכים ייחודיים ברשימה של 11,000 שורות שמשתנה לעיתים קרובות.
הפתרון הראשון הוא נוסחת מערך אחת שעושה הכל. היא ארכה 13.8 שניות.
הפתרון האחרון הוא הוספת עמודת עזר שבודקת בכל שורה אם הערך שונה מהערך שמעליה ומחזירה אחד או אפס, ואז סכימה של העמודה. אותה תוצאה בדיוק. היא ארכה 0.027 שניות.
אותה שאלה, אותם נתונים, אותו מחשב. פי חמש מאות ומשהו.
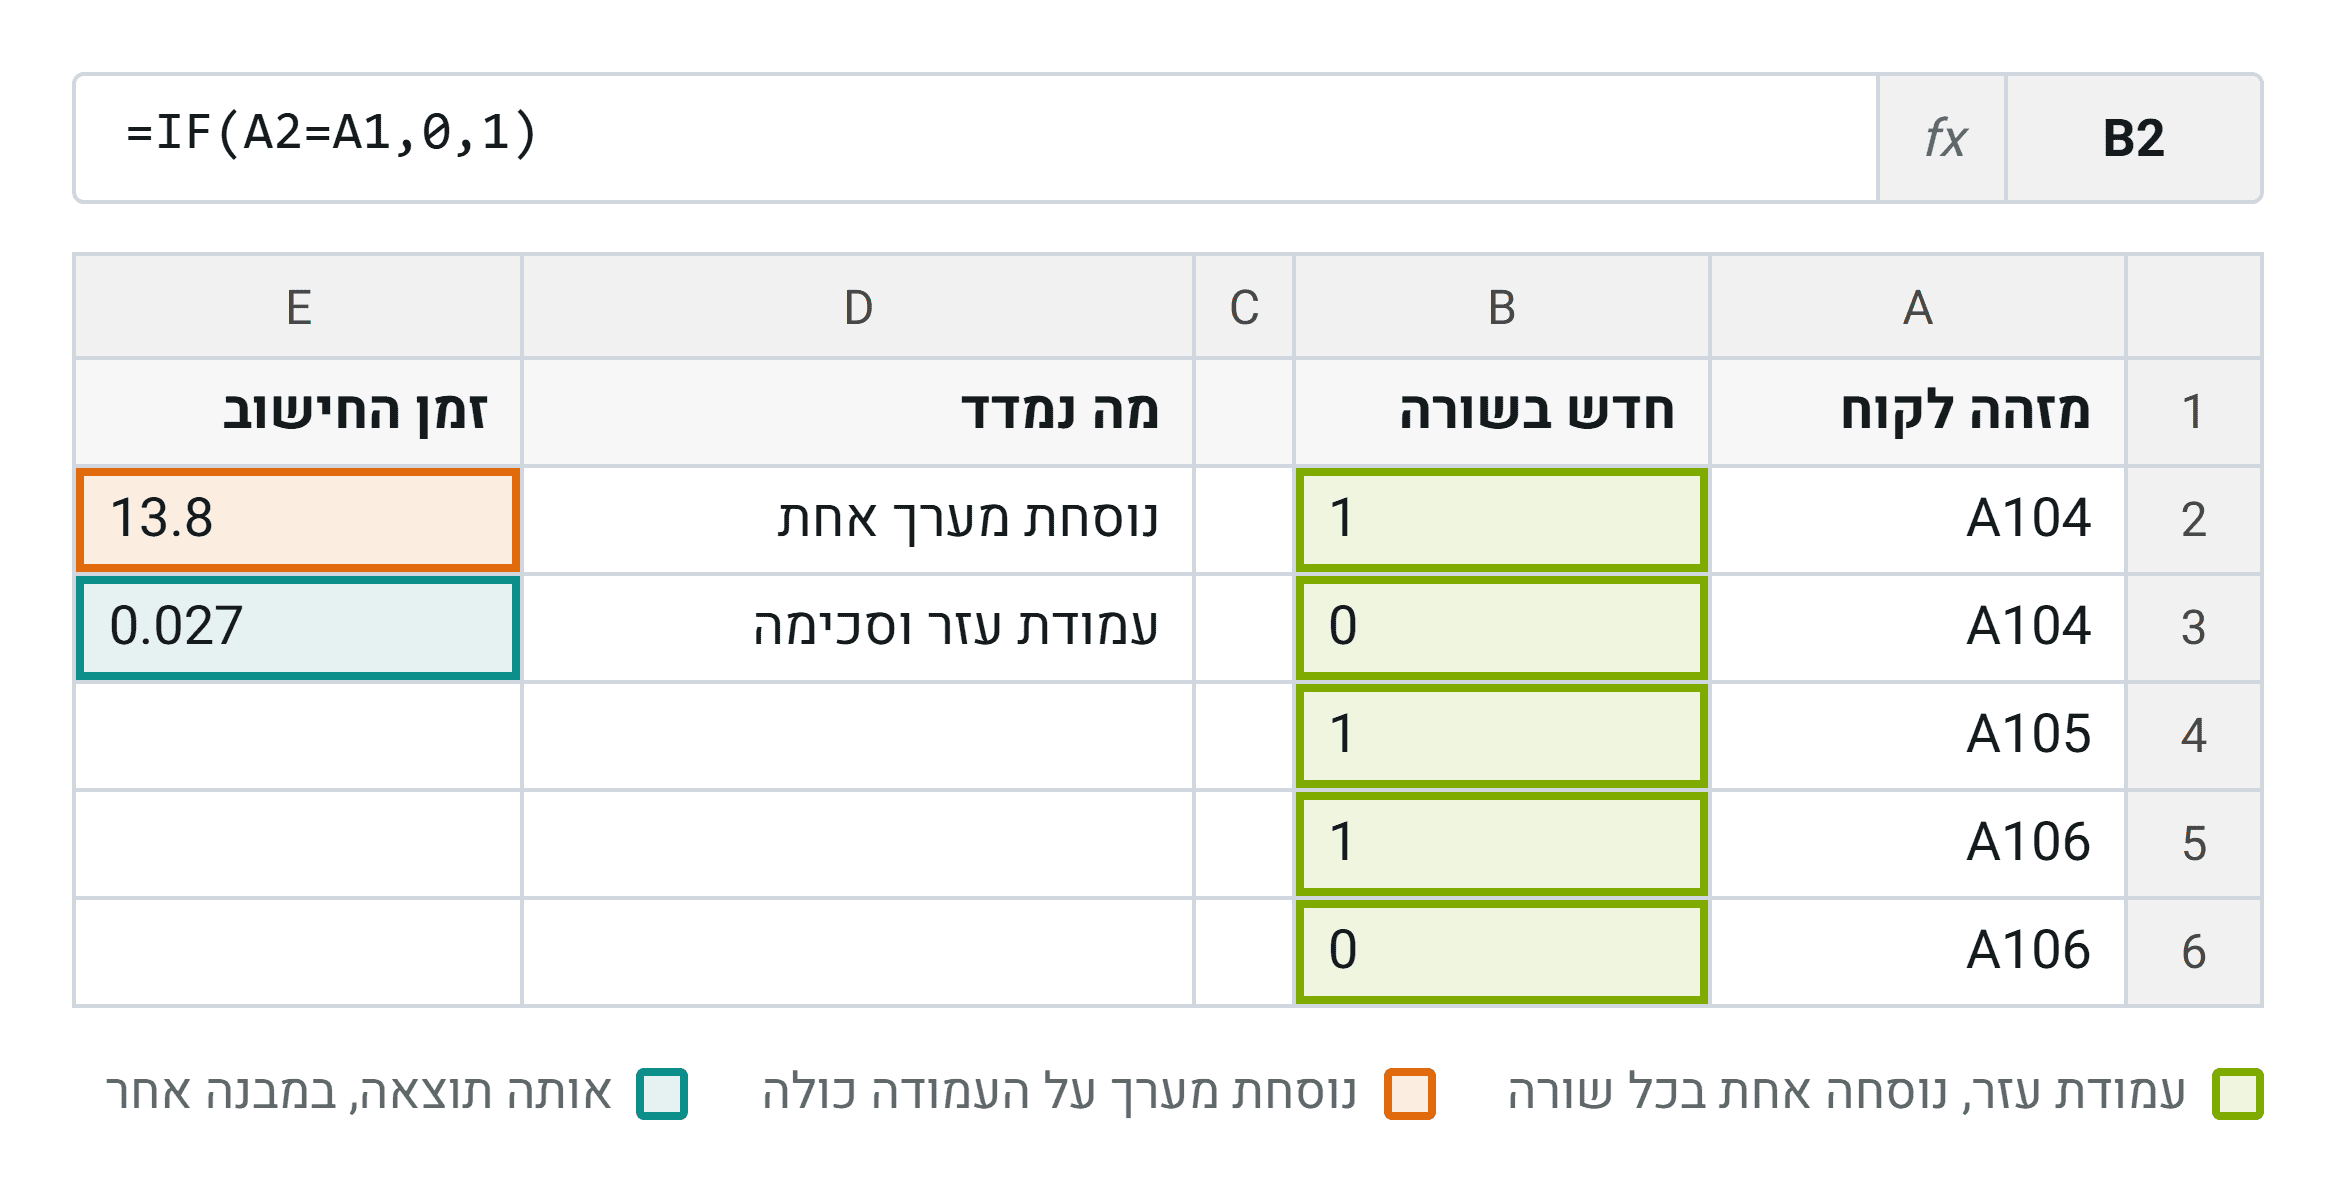
העיקרון מאחורי זה פשוט. נוסחת מערך שמפנה לעמודה שלמה מחייבת חישוב של כל התאים בעמודה, כולל התאים הריקים, וזה מיליון שורות. עמודת עזר מחשבת רק את מה שקיים, ומאפשרת למנוע החישוב החכם של אקסל לחשב מחדש רק את מה שהשתנה.
יש לזה בונוס שלא קשור למהירות. כשמשהו נשבר, בעמודת עזר רואים באיזו שורה. בנוסחת מערך ענקית רואים שגיאה אחת.
הבדיקה שלוקחת עשר דקות
אל תתחילו לתקן לפני שיש לכם מספר. אחרת לא תדעו אם שיפרתם או רק הזזתם את הבעיה.
ראשית, בכל גיליון קפצו לתא האחרון בשימוש. אם התא הזה נוחת הרבה מתחת לנתונים האמיתיים או הרבה מימין להם, יש לכם טווח בשימוש מנופח. מיקרוסופט מסבירה שפעולות עריכה ועיצוב מרחיבות את הטווח הזה הרבה מעבר לאזור שנראה בשימוש, ושזה גורם לפתיחה איטית ולקובץ מנופח. גבו עותק, מחקו את השורות והעמודות המיותרות, ושמרו.
שנית, מדדו חישוב מלא של הקובץ. זה המקרה הגרוע.
שלישית, מדדו חישוב מחדש מיד אחרי החישוב המלא. זה המקרה הטוב.
רביעית, חלקו את השני בראשון. היחס הזה הוא מדד הנדיפות של הקובץ. ככל שהוא קרוב לאחד, כך יותר עבודה נעשית מחדש בכל פעם בלי סיבה, וזה מפנה אתכם ישר אל הסיבה הראשונה והשנייה.
רק אחרי המספרים האלה שווה לפתוח נוסחה.
הכלל
מיקרוסופט מסיימת את העמוד בטענה שאפשר להאיץ את רוב הקבצים האיטיים פי עשרה ואף פי מאה. זה נשמע מוגזם עד שרואים את הפער בין 13.8 שניות ל-0.027.
אבל השורה שחשוב לקחת היא אחרת.
כל עוד הפתרון שלכם לקובץ כבד הוא חישוב ידני, לא פתרתם את הביצועים. החלפתם בעיה שרואים, קובץ שנתקע, בבעיה שלא רואים, מספר שנראה תקין ואינו מעודכן.
מי שיודע להגיד כמה זמן מחשב הקובץ שלו לא מופתע בישיבה.
והשאלה שנשארה פתוחה
נניח שעשיתם את הבדיקה, מצאתם את החנק, ותיקנתם אותו. הקובץ מחשב עכשיו מהר.
וכאן מתחילה השאלה שהמאמר הזה לא עונה עליה. איך בונים את הדוח החודשי מחדש כך שהחנק לא יחזור בעוד חצי שנה. איפה עובר הגבול שבו נכון להוציא את הנתונים מהגיליון אל שאילתה או אל מודל נתונים, מה כדאי להשאיר בנוסחאות כדי שאנשים ימשיכו להבין את הקובץ, ואיך מציגים את השינוי הזה להנהלה כך שהוא ייראה כשדרוג בקרה ולא כפרויקט טכני.
את הדיון הזה אני מנהל בתוך מועדון The UNIQUE Way, ושם נמצאת גם רשימת האבחון המלאה עם שבעת החנקים לפי סדר הבדיקה. ההצטרפות חינם.