נוסחה אחת במקום שתיים. ארגומנט אחד במקום שלושה. שורה שאפשר לקרוא בלי לספור עמודות אחורה.
החלפתם את כל החיפושים בקובץ לפונקציה XLOOKUP, וצדקתם.
ואז הקובץ יצא מהארגון.
התסמין
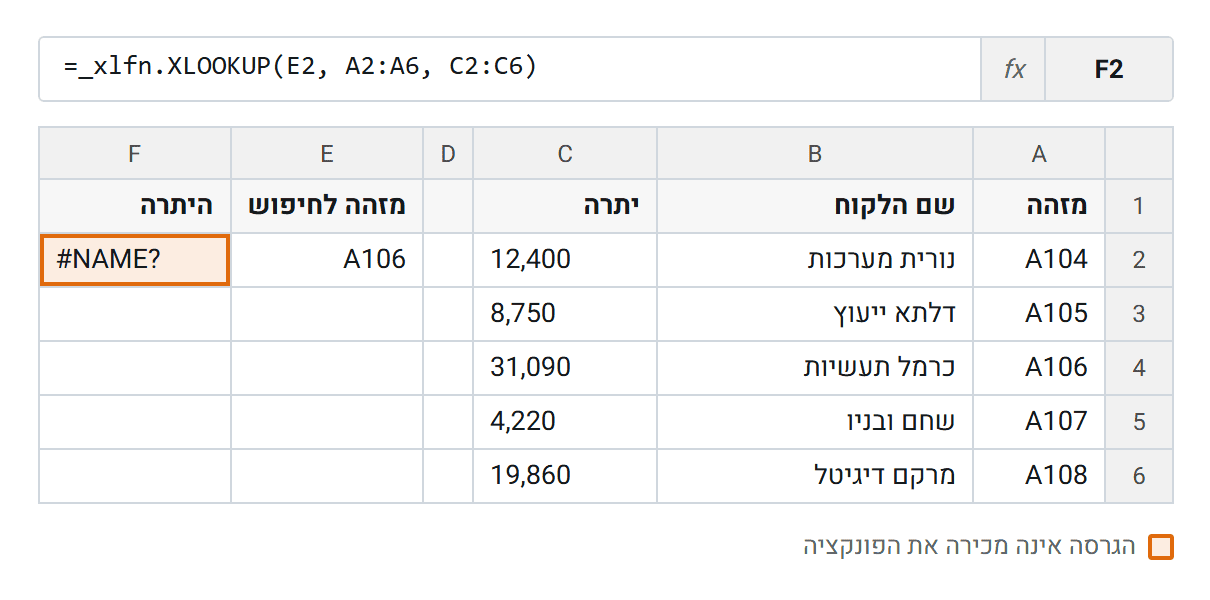
מי שקיבל את הקובץ פותח אותו ורואה שגיאה בכל תא שהייתה בו נוסחת חיפוש. בשורת הנוסחה מופיע שם שלא הקלדתם, עם קידומת קצרה שנדבקה לפני שם הפונקציה. אצלכם הקובץ עבד. אצלו הוא לא.
זה התסמין הרועש, והוא המקרה הטוב. יש לו שני אחים שקטים יותר, ושניהם מחזירים מספר במקום שגיאה.
רגע, מה זה בכלל הקידומת הזו
כשחוברת נשמרת בגרסה חדשה של Excel ונפתחת בגרסה ישנה יותר, כל פונקציה שהגרסה הישנה אינה מכירה מסומנת כפונקציה חיצונית, והסימון הזה נדבק לשם שלה בשורת הנוסחה.
מיקרוסופט מקדישה לזה עמוד תיעוד נפרד, ומסבירה שם שהקידומת מופיעה כאשר החוברת מכילה פונקציה שאינה נתמכת בגרסה שפתחה אותה. התוצאה בגיליון היא שגיאת שם, כלומר אקסל אומר שאינו מכיר את מה שכתוב.
הסיבה, ככתוב במסמכים
בעמוד התיעוד של הפונקציה XLOOKUP מופיעה רשימת הגרסאות שבהן היא קיימת, והיא מתחילה בגרסת 2021 ובמנוי החודשי. מתחת לרשימה מיקרוסופט כותבת במפורש שהפונקציה אינה זמינה באקסל 2016 ובאקסל 2019, ומוסיפה שייתכן שתיתקלו בחוברת שמשתמשת בה דווקא שם, אם מישהו אחר יצר אותה בגרסה חדשה יותר.
ובעמוד התיעוד של הפונקציה INDEX, רשימת הגרסאות כוללת את אקסל 2016 ואת אקסל 2019. אותו דבר בעמוד של MATCH.
זה כל ההבדל, והוא לא על איכות.
מי שכל הקבצים שלו נשארים בתוך ארגון שעבר למנוי החודשי לא ייפגש בזה לעולם. מי ששולח קובץ לרואה חשבון, לבנק, לרשות או לספק, נפגש בזה ביום שבו הצד השני לא שדרג. השאלה מי מקבל את הקובץ אינה שאלה טכנית, והיא נשאלת לפני כתיבת הנוסחה ולא אחריה.
הטעות שאין לה שגיאה
לפונקציה XLOOKUP יש ארגומנט חמישי שקובע את אופן החיפוש, ושני ערכים בו מבקשים חיפוש בינארי.
רגע, מה זה בכלל חיפוש בינארי
זו שיטה שמנחשת באמצע הרשימה, בודקת אם הערך שם גדול או קטן מזה שחיפשתם, וזורקת מיד את החצי שאינו רלוונטי. היא חוזרת על זה עד שהיא מגיעה לערך, ולכן היא מהירה בהרבה מסריקה שורה אחרי שורה.
היא נכונה בתנאי אחד בלבד: שהרשימה ממוינת. אם היא אינה ממוינת, כל ניחוש מוביל לחצי הלא נכון.
בתיעוד של מיקרוסופט התנאי הזה כתוב במפורש, ומיד אחריו משפט אחד: אם הטווח אינו ממוין, יוחזרו תוצאות שגויות. לא שגיאה. תוצאות.
ולפני שממהרים להאשים פונקציה אחת, כדאי לדעת שהמלכודת הזו אינה שלה. לפונקציה MATCH יש בדיוק את אותו תנאי. הארגומנט השלישי שלה מקבל שלושה ערכים, ובתיעוד כתוב שעבור אחד מהם הטווח חייב להיות ממוין בסדר עולה, עבור השני בסדר יורד, ורק עבור הערך שמבקש התאמה מדויקת הטווח יכול להיות בכל סדר.
וכאן ההבדל דווקא לרעת הוותיקה. באותו עמוד כתוב שכאשר הארגומנט מושמט, ברירת המחדל היא הערך שמניח מיון עולה. כלומר מי שכתב נוסחה וסגר סוגריים בלי לכתוב אפס בסוף כבר עובד שנים עם הנחה שאיש לא בדק.
ההתאמה שנכשלת בלי סיבה נראית לעין
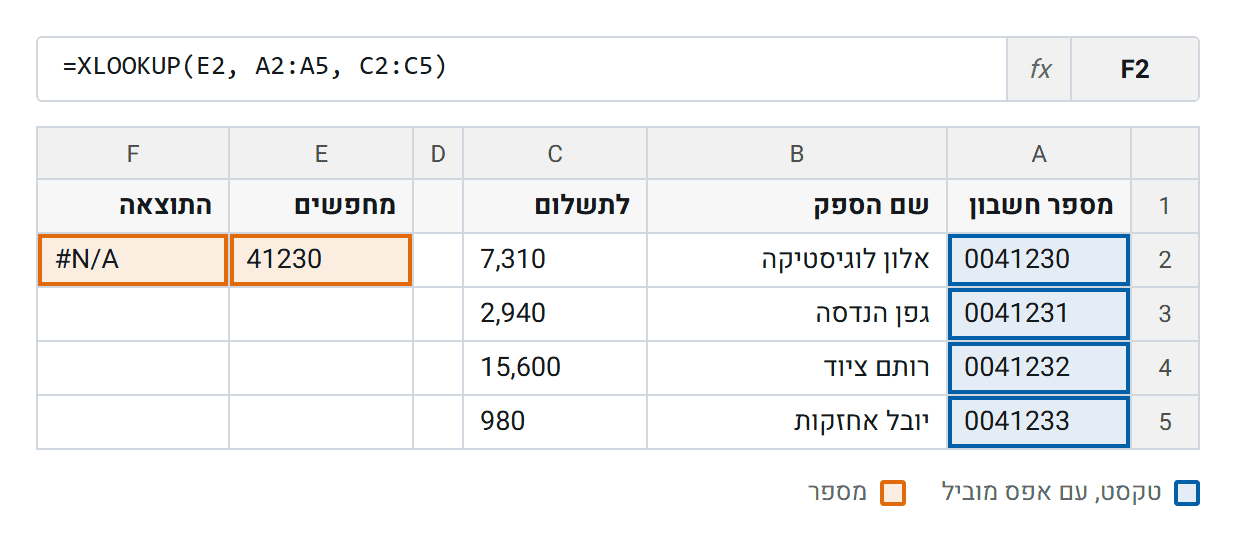
בקהילת אקסל ברדיט נשאלה השבוע שאלה שכל מי שמושך נתונים ממערכת ארגונית מכיר. איך מגנים על חיפוש כשהמספרים שמורים בכוונה כטקסט. מספר חשבון עם אפס מוביל, מספר ספק, קוד סניף.
הערך נראה זהה בשני הצדדים של הנוסחה, ובכל זאת אין התאמה.
התשובה שסומנה כפתרון בדיון היא להכריח את שני הצדדים לאותו סוג. אפשר בהוספת מחרוזת ריקה גם לערך המבוקש וגם לעמודה שבה מחפשים, ואפשר בעטיפת שניהם בפונקציית טקסט עם אותה תבנית. המסקנה החוזרת שם היא שהתאמה בין טקסט למספר אינה מתרחשת מעצמה, ולכן חיפוש נכשל אף שהעין רואה את אותו ערך.
מה שקשה לשחזר בפונקציה יחידה
עד כאן זה נשמע כמו הגנה על שתי פונקציות ותיקות מטעמי תאימות בלבד. יש להן גם יתרון מבני, והוא כתוב בתיעוד בשתי שורות שקל לפספס.
השורה הראשונה נמצאת בעמוד של MATCH, והיא אומרת שהפונקציה מחזירה את המיקום של הערך בתוך הטווח, ולא את הערך עצמו.
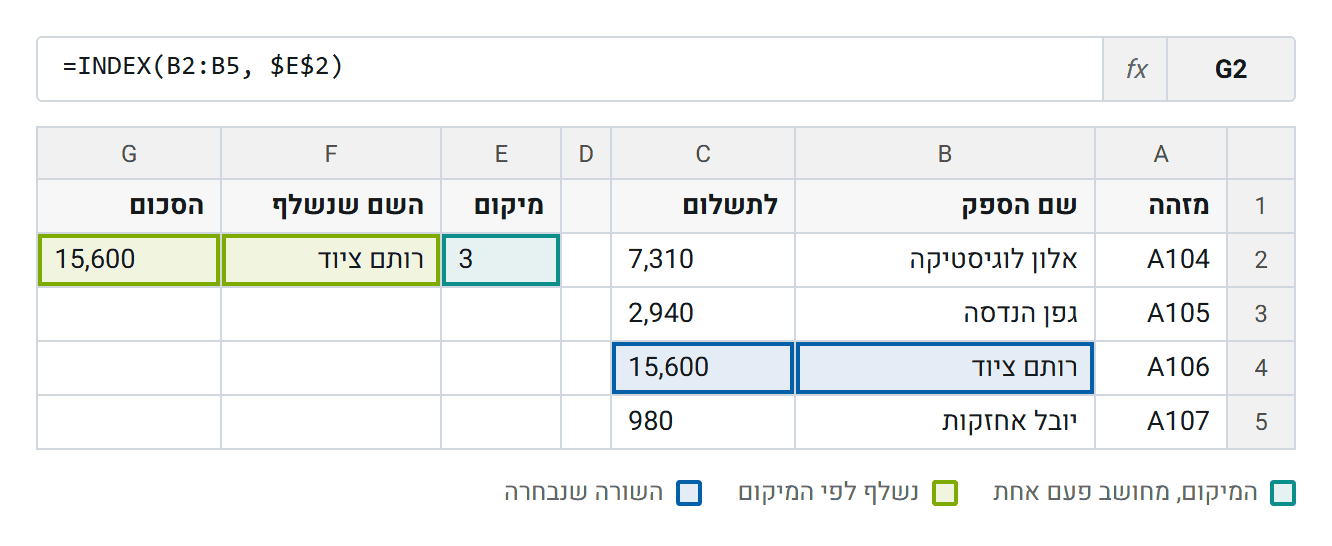
כדאי לעצור על זה רגע, כי בדוח רחב זה ההבדל היחיד שמשנה. נניח טבלת עובדים או ספקים, ושורת סיכום ששולפת ממנה שתים עשרה עמודות. עם חיפוש רגיל, כל אחת משתים עשרה העמודות מריצה חיפוש נפרד על אותה עמודת מפתח בדיוק. השילוב INDEX MATCH באקסל מפריד בין שתי הפעולות: מחשבים את המיקום פעם אחת בתא נפרד, ושתים עשרה השליפות רק מצביעות עליו.
הרווח הראשון הוא מהירות. הרווח השני חשוב ממנו, והוא בקרתי. כשהמיקום יושב בתא גלוי, מי שבודק את הדוח רואה איזו שורה נבחרה. בנוסחה סגורה אי אפשר לראות את זה בלי לפרק אותה.
השורה השנייה נמצאת בעמוד של INDEX, ושם כתוב שתוצאת הפונקציה היא הפניה ושפונקציות אחרות מפרשות אותה ככזו. לכן אפשר להשתמש בה בשני צדי הנקודתיים ולקבל טווח שנקבע בזמן החישוב, במקום טווח קבוע שמישהו יצטרך לעדכן ידנית.
וצריך לומר גם את הצד השני: הפונקציה החדשה מחזירה אף היא הפניה, ומיקרוסופט מדגימה זאת בעמוד שלה. היתרון של השילוב הוותיק אינו בהפניה, הוא בהפרדה בין החיפוש לשליפה.
סדר האבחון
ארבע שאלות, וכולן נשאלות לפני כתיבת הנוסחה.
ראשית, לאן הקובץ הולך. אם הוא נשלח מחוץ לארגון, השאלה על הגרסה בצד השני היא הראשונה ברשימה ולא האחרונה.
שנית, האם עמודת המפתח ממוינת. אם התשובה אינה ודאית, אל תבקשו חיפוש בינארי ואל תשאירו את הארגומנט של MATCH ריק.
שלישית, מה סוג הערך. מספר, טקסט, או מספר ששמור כטקסט. השלישי הוא זה שנופל, והוא נפוץ בדיוק בשדות שמזהים לקוח או ספק.
רביעית, כמה עמודות אתם שולפים מאותה שורה. אם התשובה גדולה מאחת, חישוב מיקום אחד עדיף על סדרה של חיפושים נפרדים.
התיקון
שלושה שינויים בהרגל, ואף אחד מהם אינו דורש כתיבת קוד.
בדקו את היעד לפני הנוסחה. זו בדיקה של שנייה אחת, והיא חוסכת את המייל שחוזר.
כתבו את הארגומנט השלישי במפורש. אפס בסוף הנוסחה הוא ההבדל בין התאמה מדויקת לבין הנחה על מיון.
והוציאו את המיקום לתא נפרד בכל דוח שמושך יותר מעמודה אחת. הנוסחה נעשית ארוכה בשורה אחת, והדוח נעשה ניתן לבדיקה.
הכלל
הבחירה בין פונקציות החיפוש אינה בחירה בין ישן לחדש, והיא גם לא עניין של טעם.
לקובץ שנשאר בפנים ושולף ערך אחד, הפונקציה החדשה קצרה יותר וקריאה יותר, ואין סיבה לוותר עליה. לקובץ שיוצא החוצה, או לדוח שמושך שתים עשרה עמודות מאותה שורה, השילוב הוותיק עדיין עושה עבודה שקשה לשחזר.
מי שהחליף את הכל בבת אחת לא בחר. הוא רק החליף.
והשאלה שנשארה פתוחה
נניח שעברתם על הקובץ, בדקתם את היעד, תיקנתם את הארגומנטים והוצאתם את המיקום לתא נפרד. הדוח נכון היום.
וכאן מתחילה השאלה שהמאמר הזה לא עונה עליה. מאיזה גודל של טבלה נכון להפסיק לחפש בנוסחאות בכלל ולהעביר את החיבור בין הטבלאות למודל, מה משאירים גלוי בגיליון כדי שאנשים ימשיכו להבין מאיפה הנתון הגיע, ואיך מציגים את המעבר הזה להנהלה כך שהוא ייראה כשדרוג בקרה ולא כפרויקט טכני.
את הדיון הזה אני מנהל בתוך מועדון The UNIQUE Way, ושם נמצאת גם מפת ההחלטה המלאה לפונקציות החיפוש, עם טבלת התאימות לפי גרסה. ההצטרפות חינם.