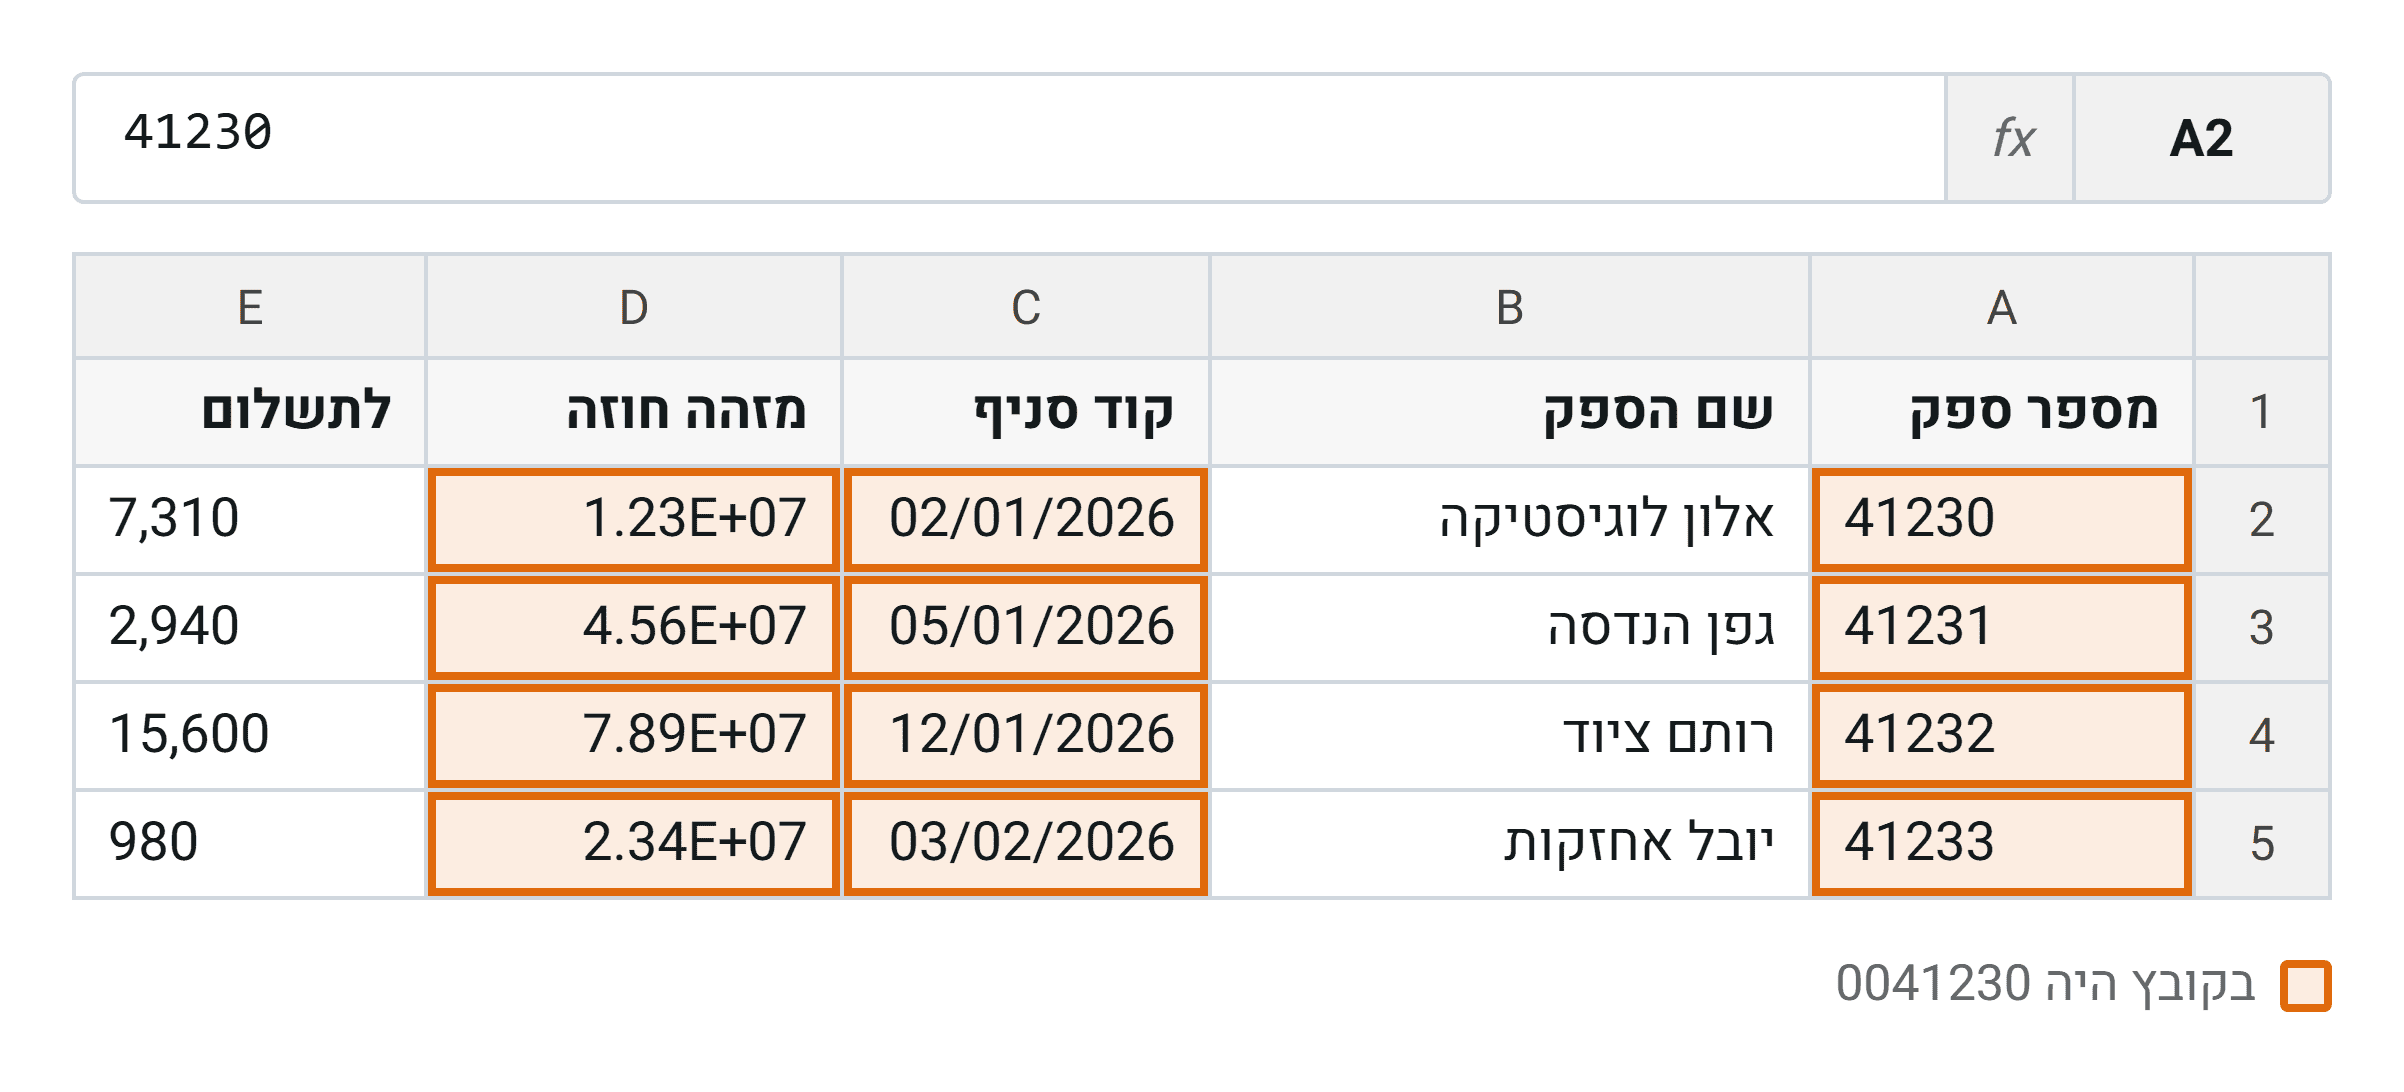
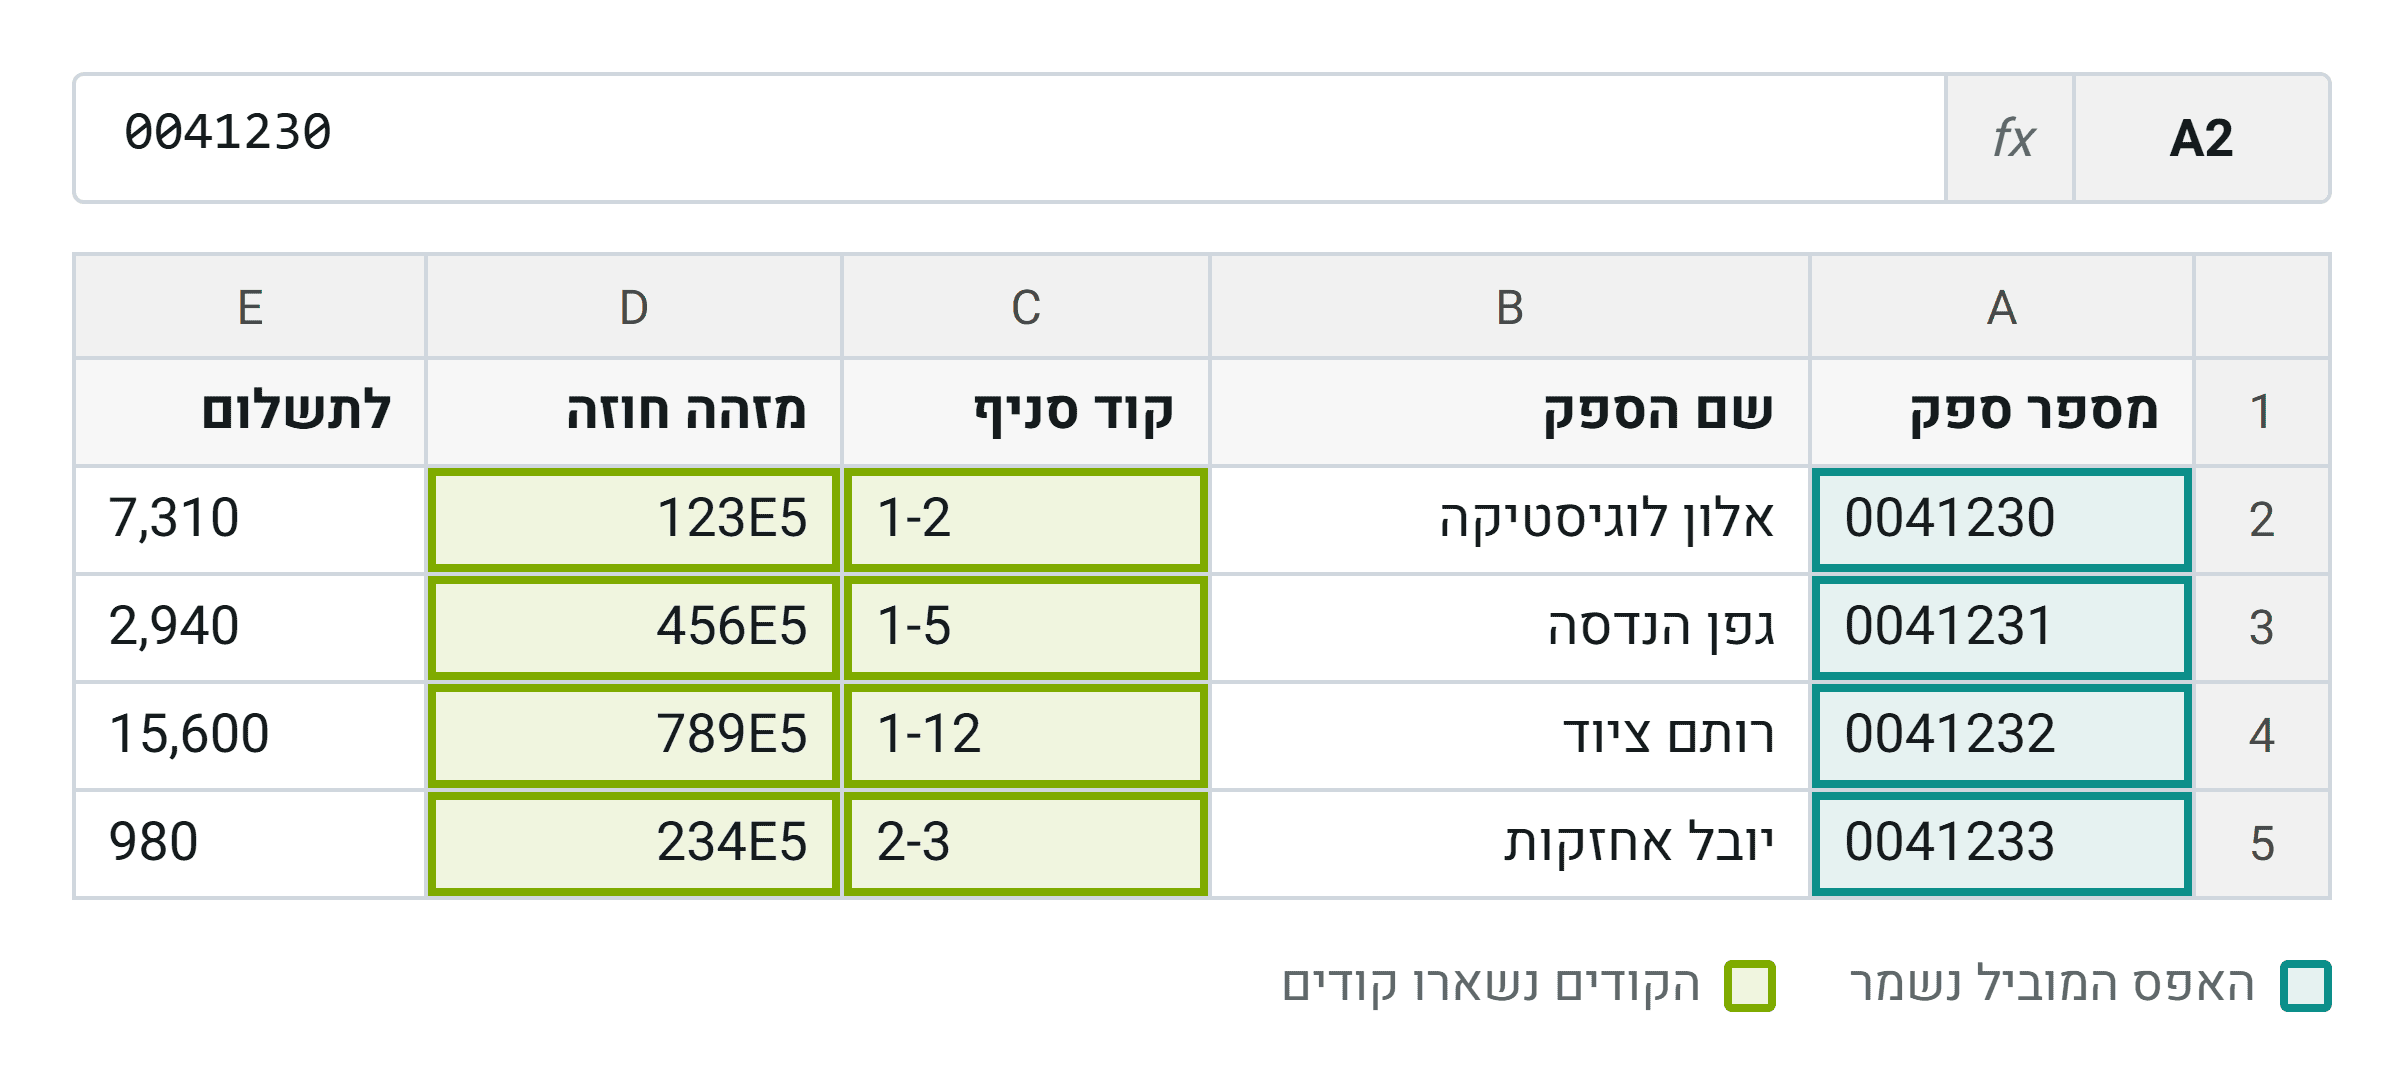
מספר ספק שהיה בקובץ: 0041230. קוד סניף שהיה בקובץ: 1-2. מזהה חוזה שהיה בקובץ: 123E5.
שלושה שדות, ואף אחד מהם לא נמצא בגיליון שפתחתם. הראשון איבד את האפס המוביל. השני הפך לתאריך. השלישי הפך למספר בכתיב מדעי.
והקובץ נראה תקין לחלוטין.
התסמין
אף אחת משלוש ההמרות האלה אינה מייצרת שגיאה. אין משולש אדום בפינת התא, אין הודעה, ואין שום סימן שמשהו הוחלף. יש ערך, הוא נראה סביר, והוא פשוט אינו הערך שהיה בקובץ.
והכתיב המדעי, אם המונח לא מוכר, הוא דרך מקוצרת להציג מספר גדול מאוד: 1.23E+07 במקום 12,300,000. בעמודה שהיא כמות זה קיצור לגיטימי, ובעמודה שהיא קוד זה מוחק את הקוד.
הסימן היחיד שנראה לעין בלי לפתוח שום תא הוא היישור. עמודה שאמורה להכיל קוד ומיושרת לימין היא עמודה שאקסל החליט שהיא מספר. עמודת טקסט מיושרת לצד השני.
למה זה קורה
השבוע עלתה בקהילת אקסל ברדיט שאלה שמנוסחת כתלונה: איך ייתכן שאין באקסל הגדרה גורפת שמונעת שינוי אוטומטי של הדרך שבה מספר מוצג. השאלה אספה ביקוש גבוה בתוך ימים, וזו בדיוק השאלה ששומעים בכל מחלקה שמושכת נתונים ממערכת ארגונית.
התשובה, ואותה כמעט אף אחד לא נותן: ההגדרה קיימת.
בתיעוד של מיקרוסופט מופיעה קטגוריה בשם המרת נתונים אוטומטית. במערכת ההפעלה של חלונות היא יושבת תחת קובץ, אפשרויות, נתונים. במק המסלול הוא Excel, העדפות, עריכה.
יש שם תיבת סימון ראשית שמפעילה את כל ההמרות יחד, ומתחתיה ארבע תיבות נפרדות:
הראשונה מסירה אפסים מובילים וממירה למספר. השנייה שומרת את חמש עשרה הספרות הראשונות של מספר ארוך ומציגה אותו בכתיב מדעי. השלישית ממירה ספרות שמקיפות את האות הלטינית שבאמצע לכתיב מדעי. הרביעית ממירה רצף של אותיות וספרות לתאריך.
ובאותו מסך יש תיבה חמישית, והיא השימושית מכולן: בקשה לקבל הודעה על כל המרה אוטומטית בעת טעינת קובץ מסוג csv או דומה. היא אינה מונעת דבר, אבל היא אומרת לכם שקרתה המרה. בלעדיה, הקובץ נראה תקין וזהו.
באותו עמוד תיעוד מפורטים גם המצבים שבהם ההמרה מתרחשת, והם חמישה: פתיחת קובץ מסוג csv או txt, הקלדה, הדבקה ממקור חיצוני, חיפוש והחלפה, והאשף שממיר טקסט לעמודות. שימו לב לשניים האחרונים. הם קורים בתוך קובץ שכבר פתוח ותקין, ולכן אף אחד לא חושד בהם.
הגבול, וזה החלק שאף מדריך לא מספר
עד כאן זה נשמע כמו סוף הסיפור. סמנו ארבע תיבות, וגמרנו.
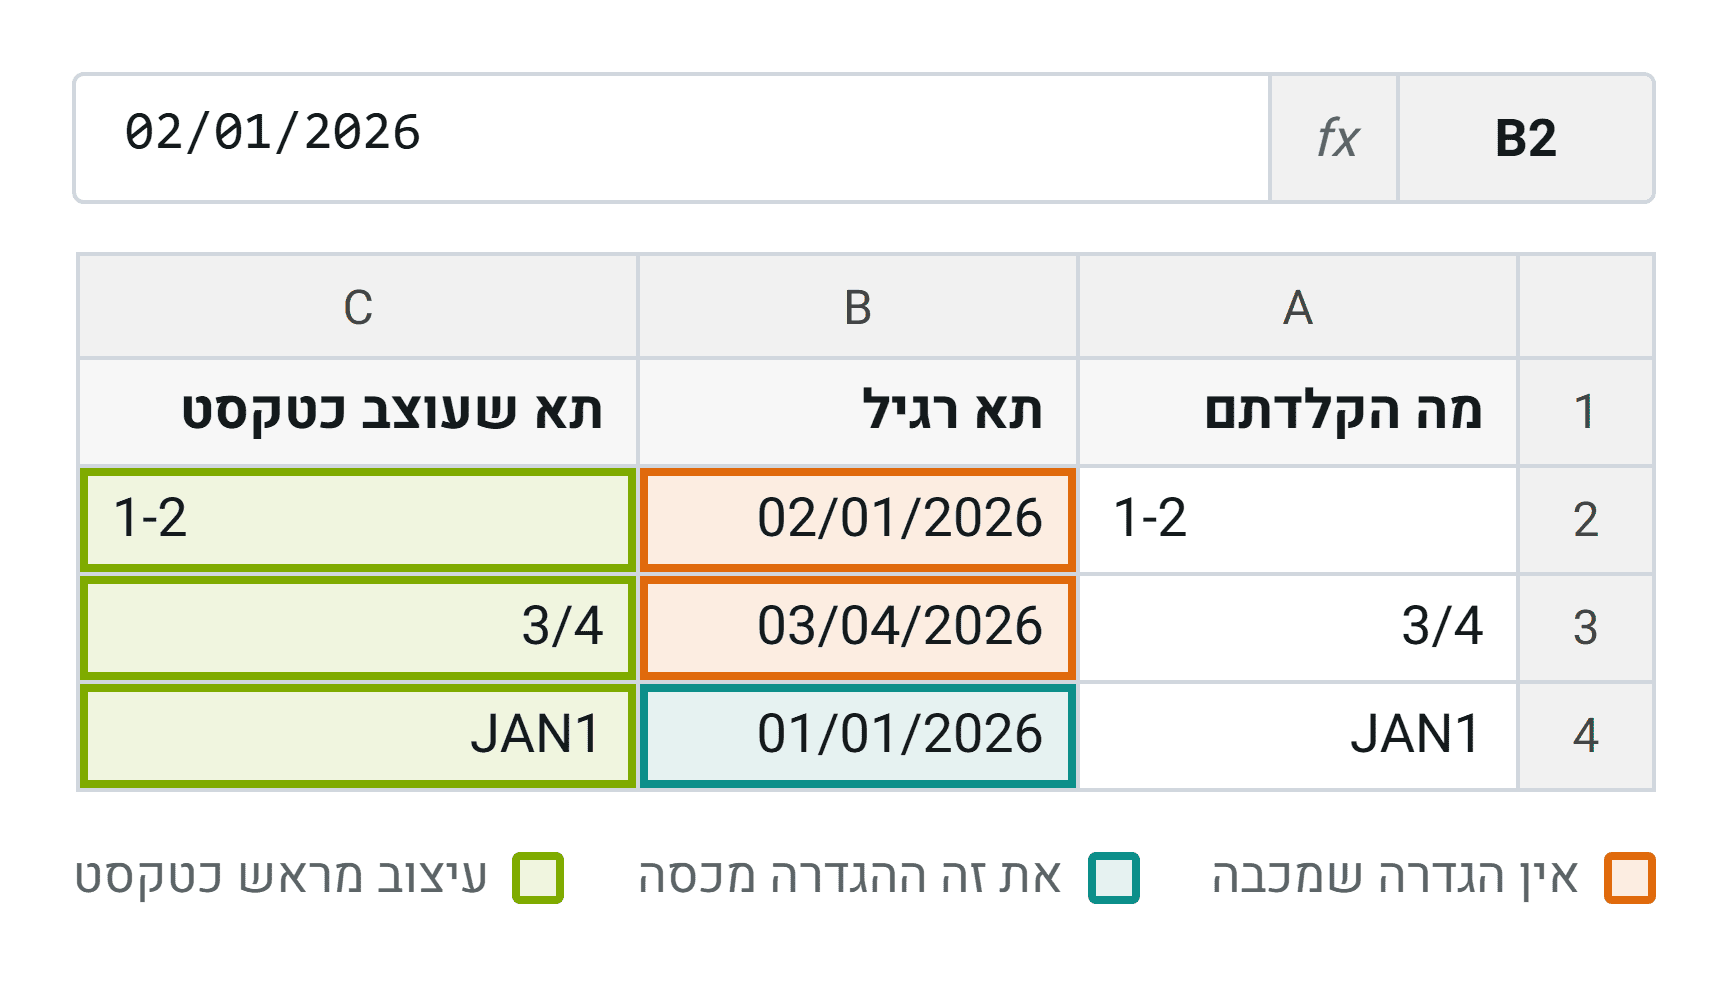
ההגדרות מכסות ארבע המרות שמוגדרות בשם. ערך כמו 1-2 או 3/4 שהופך לתאריך אינו אחת מהן, והוא המקרה הנפוץ ביותר.
בעמוד תיעוד נפרד, שעוסק בדיוק בהמרה של מספרים לתאריכים, מיקרוסופט כותבת שאין דרך לכבות אותה. במקום זה היא מציעה שלוש דרכים: לעצב את התאים כטקסט לפני ההקלדה, להקדים לערך רווח, או להקדים לו גרש.
כלומר מי שסימן את ארבע התיבות והרגיש מוגן קיבל הגנה חלקית. הגנה חלקית על שדה מזהה היא לא הגנה, כי מספיק שדה אחד שגוי כדי שהתאמה מול טבלה אחרת תיכשל.
סדר האבחון
ארבע בדיקות, וכולן לפני שהקובץ יוצא מהמחשב שלכם.
ראשית, האם יש בקובץ שדה מזהה שמתחיל באפס. מספר ספק, קוד סניף, מספר חשבון, מספר לקוח.
שנית, האם יש שדה שאורכו שש עשרה ספרות ומעלה. בתיעוד כתוב שהדיוק המרבי הוא חמש עשרה ספרות משמעותיות, וכל ספרה מעבר לכך מעוגלת לאפס. ספרו את הספרות, ואל תסתמכו על רוחב העמודה.
שלישית, האם יש עמודה שאמורה להיות קוד ומיושרת לימין.
רביעית, האם צצו תאריכים במקומות שלא אמורים להיות בהם תאריכים.
התיקון
שלושה מסלולים, ולכל אחד המצב שלו. רק אחד מהם נשמר.
לתא בודד, גרש לפני הערך. אקסל מקבל אותו כטקסט. זה תיקון נקודתי ולא פתרון לקובץ.
לטווח שעומדים להקליד אליו, עיצוב כטקסט מראש. סימון הטווח, פתיחת עיצוב תאים, ובלשונית מספר בחירה בטקסט. בתיעוד יש לזה תנאי מפורש שכדאי לקרוא לפני שסומכים עליו: העיצוב משפיע רק על מה שנכנס אחריו, והוא אינו מחזיר אפסים מובילים שכבר הוסרו.
ולקובץ שחוזר כל חודש, המסלול היחיד שמחזיק: לא לפתוח אותו בלחיצה כפולה, אלא לייבא אותו.
רגע, מה זה בכלל Power Query
זה חלון שיושב בתוך אקסל ומתעד את שלבי הניקוי של הנתונים לפני שהם נכנסים לגיליון. במקום לתקן ידנית בכל פעם שהקובץ מתעדכן, מגדירים פעם אחת מה עושים, והשלבים רצים שוב לבד בעדכון הבא.
המסלול, כפי שהוא מתועד: בלשונית נתונים בוחרים מתוך טקסט או csv, ואז בוחרים טרנספורמציה של הנתונים במקום טעינה ישירה. בחלון שנפתח מסמנים את עמודת המזהה, ובלשונית בית בוחרים סוג נתונים, ואז טקסט. רק אחרי זה טוענים לגיליון.
ההבדל בין המסלול הזה לשניים הראשונים אינו בכמות העבודה, והוא גם לא בקושי. הוא בזה שההחלטה על העמודה נשמרת בתוך הקובץ, ורצה שוב לבד בפעם הבאה.
הכלל
השאלה כאן אינה איך מבטלים תכונה מעצבנת. אקסל מנחש מה כל עמודה מכילה, והניחוש הזה נכון ברוב המקרים ובדיוק בגלל זה הוא מסוכן בשדות מזהים.
הכלל הוא פשוט: אפס מוביל באקסל הוא סימן לכך שהשדה אינו מספר אלא מזהה. מזהה לא מחשבים, לא מסכמים ולא ממוצעים. מזהה משווים, ולכן הוא חייב להישאר בדיוק כפי שהיה במערכת שהוציאה אותו.
מי שמכיר את ההבחנה הזו יודע מתי לסמן לעמודה שהיא טקסט, ולא צריך לזכור רשימת תקלות.
והשאלה שנשארה פתוחה
נניח שסימנתם את ארבע התיבות, שהוספתם את ההודעה על המרות, ושהחלפתם את הפתיחה בייבוא מסודר. הקובץ החודשי נכנס נכון.
וכאן מתחילה השאלה שהמאמר הזה לא עונה עליה. מאיזה נפח נכון להפסיק לתחזק את הניקוי הזה בכל קובץ בנפרד ולהעביר אותו לשכבה אחת שכל הדוחות יושבים עליה, מה נשאר גלוי בגיליון כדי שאנשים ימשיכו להבין מאיפה הנתון הגיע, ואיך מציגים את המעבר הזה להנהלה כך שהוא ייראה כשדרוג בקרה ולא כפרויקט טכני.
את הדיון הזה אני מנהל בתוך מועדון The UNIQUE Way, ושם נמצאת גם רשימת הבדיקה המלאה לייבוא נתונים, עם ארבע ההגדרות בשמות המדויקים וחמש הבדיקות לפני ששולחים קובץ החוצה. ההצטרפות חינם.