מספר הספק בדוח הוא 1042. מספר הספק בטבלת הספקים הוא גם הוא 1042. שני התאים נראים זהים לחלוטין על המסך.
על פניו זו הפונקציה הפשוטה ביותר בגיליון. אבל החיפוש מחזיר שגיאה, והערך יושב שם, שלוש שורות למטה.
ואז מישהו מקליד את המספר ידנית בתוך הנוסחה, זה עובד, והמסקנה היא שהנתונים תקינים והנוסחה מתנהגת מוזר. זו המסקנה ההפוכה בדיוק. ההקלדה הידנית לא הוכיחה שהנתונים תקינים, היא הוכיחה שהם אינם.
התסמין, ולמה הוא לא נראה כמו תקלה
מה שהקלדתם הוא מספר. מה שיושב בעמודה הוא טקסט. אותם ארבעה תווים, שני סוגים של ערך, ותצוגה זהה לגמרי.
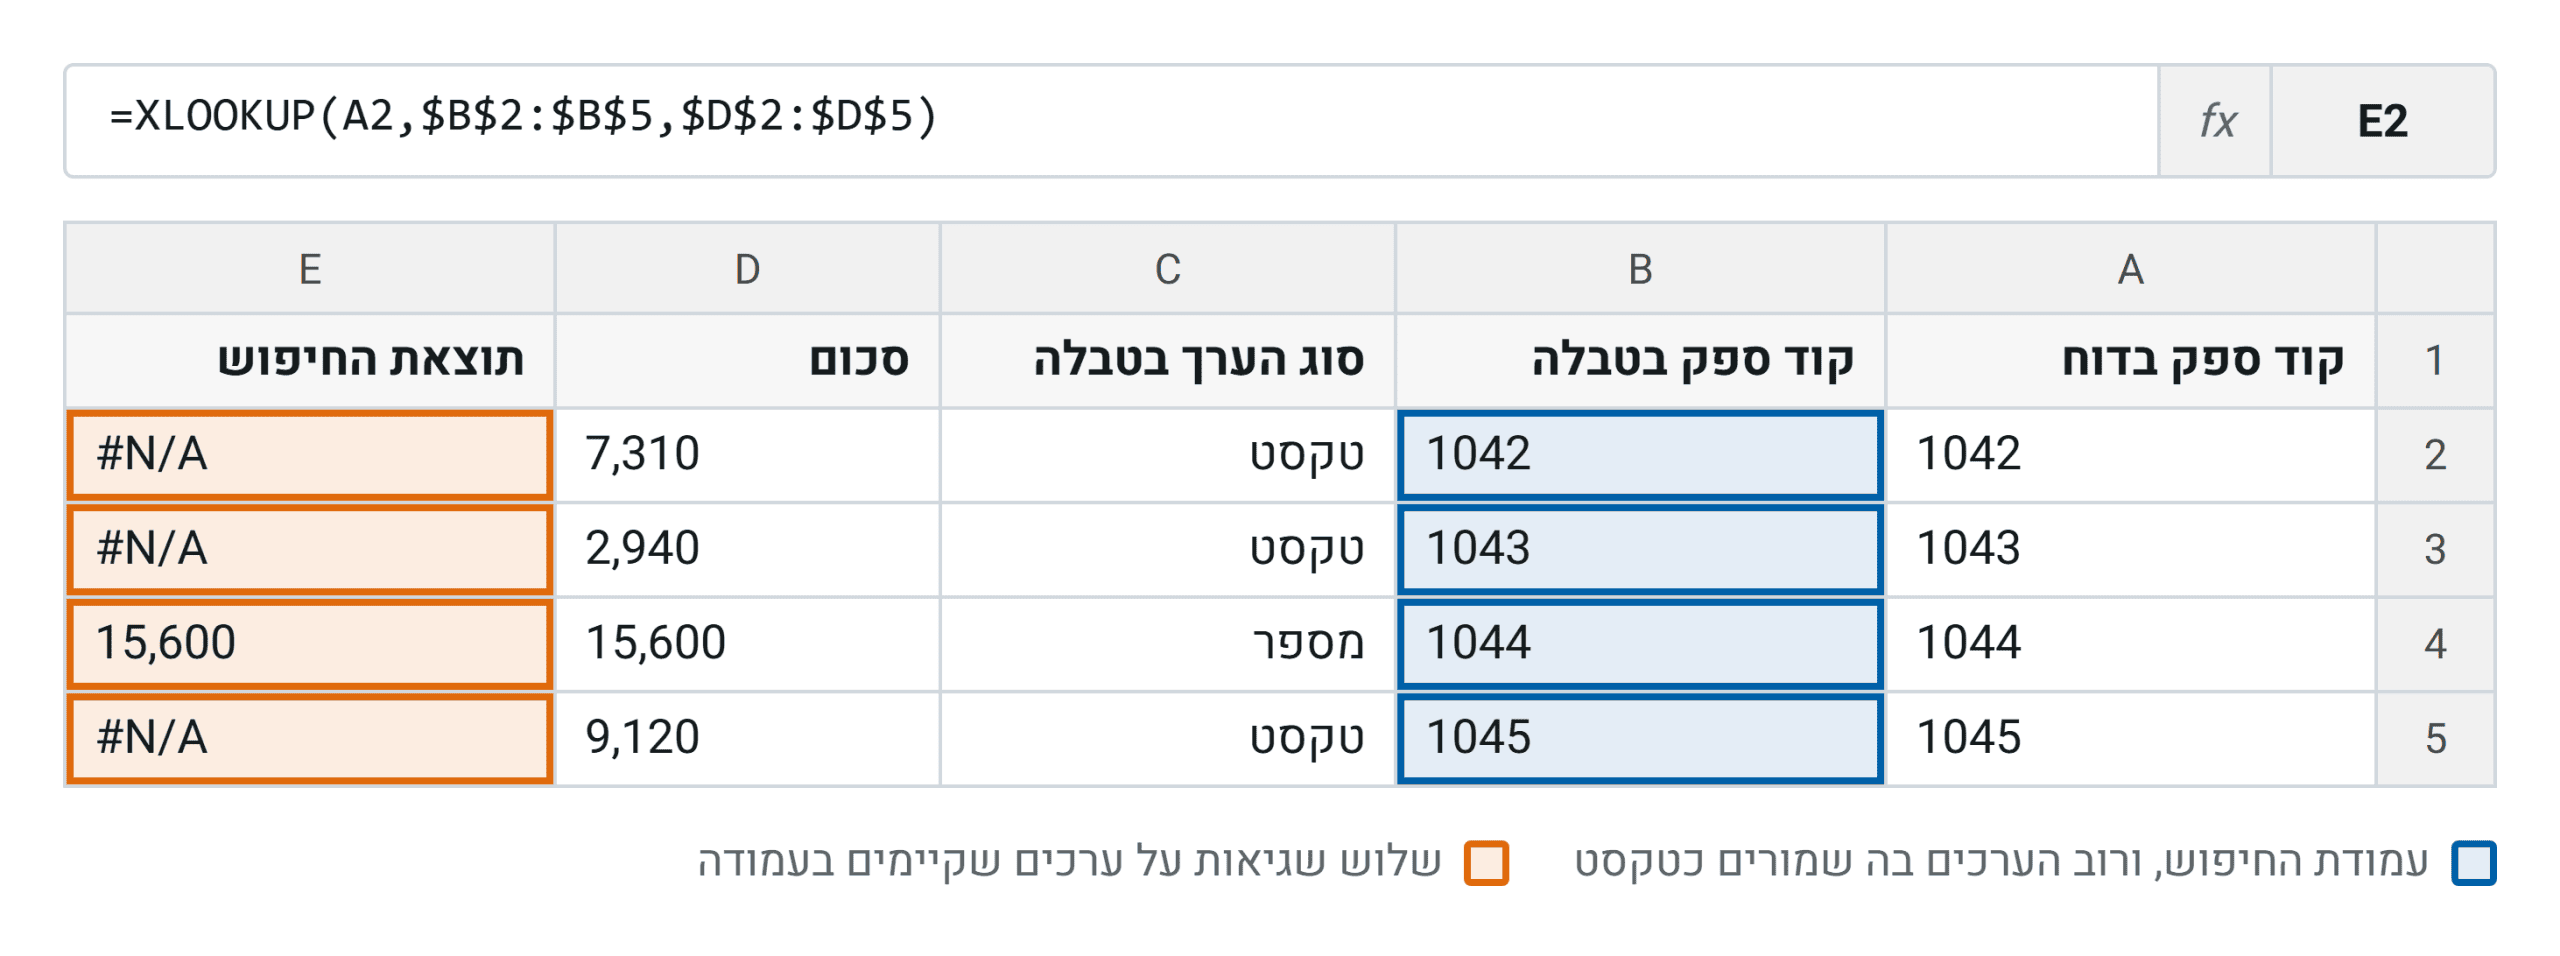
זה קורה כמעט תמיד באותו מקום: קובץ שהגיע מייצוא של מערכת. מערכת שמוציאה מזהים שומרת אותם כטקסט בכוונה, כדי לא לאבד אפס מוביל, וגיליון אחר באותו ארגון שומר את אותם מזהים כמספרים. ברגע שמחברים ביניהם, חצי מהשורות עובדות וחצי לא, וזה הדפוס שהכי קשה לזהות. תקלה שנופלת על כל השורות נראית כמו תקלה. תקלה שנופלת על שליש מהן נראית כמו נתונים חסרים.
רגע, מה זה בכלל מספרים שנשמרו כטקסט
בכל תא באקסל יושב ערך, ולערך הזה יש סוג. אותם תווים יכולים להיות שמורים כמספר או כמחרוזת טקסט, ומה שמוצג על המסך זהה בשני המקרים.
הסימן היחיד שנראה בעין הוא היישור. מספר נדבק לצד אחד של התא, טקסט לצד השני, וברגע שמישהו יישר את העמודה ידנית כדי שתיראה מסודרת, גם הסימן הזה נעלם.
למה החישוב עובד והחיפוש לא
בתיעוד של הפונקציה שממירה טקסט למספר מיקרוסופט כותבת משפט שמסביר את כל הבלבול: בדרך כלל אין צורך בפונקציה הזו בנוסחה, מכיוון שאקסל ממיר טקסט למספרים כשנדרש, והיא קיימת בעיקר לצורך תאימות לתוכנות גיליון אחרות.
זה נכון, והוא באמת עושה את זה. בחישוב.
בחיפוש הוא לא. חיפוש אינו חישוב, הוא השוואה. הוא מחפש ערך שזהה לערך שביקשתם, וערך טקסט וערך מספרי אינם אותו ערך גם כשהם נראים אותו דבר. בפורום התמיכה של מיקרוסופט התשובה שהתקבלה לשאלה כזו מנוסחת בדיוק כך: מכיוון שמדובר בשני סוגים שונים, הפונקציה אינה יכולה להתייחס אליהם כאל אותו דבר.
ושווה להכיר את הארגומנט הרביעי של פונקציית החיפוש. בתיעוד כתוב שכאשר לא נמצאה התאמה תקפה והארגומנט הזה חסר, מוחזרת שגיאת אין נתון. הוא לא יפתור את בעיית הסוגים, אבל הוא יהפוך שגיאה שמפילה כל חישוב שמתבסס עליה לערך שאפשר לסנן ולספור.
הנזק שאף אחד לא רואה
השגיאה בעמודת החיפוש לפחות צועקת. יש נזק שני, והוא שקט לגמרי.
בתיעוד של הפונקציה שמסכמת טור כתוב במפורש שהיא מתעלמת מערכי טקסט ומחזירה את הסכום של הערכים המספריים בלבד. תרגמו את זה לעמודת סכומים שהגיעה מייצוא: אם ארבע שורות בה נשמרו כטקסט, הסכום בתחתית הטור נמוך יותר, ואין שגיאה, אין הודעה, ואין שום סימן בשורת הסיכום.
אקסל אמנם מסמן תא כזה במשולש ירוק, ובאפשרויות בדיקת השגיאות יש כלל ייעודי שדולק כברירת מחדל. אבל המשולש יושב על התא הבודד ולא על הסכום, ובקובץ עם אלפי שורות הוא הופך לרעש שמישהו כיבה מזמן.
הסכום הזה נכנס לדוח. הוא נראה סביר. הוא נבדק מול החודש שעבר ולא מול המערכת, כי ההשוואה למערכת לוקחת זמן.
סדר האבחון, שלוש בדיקות בשלושים שניות
הכניסו שלוש עמודות עזר ליד העמודה החשודה, ואל תנחשו. הן עונות על שלוש שאלות שונות, ורק שלושתן יחד נותנות תשובה.
הראשונה שואלת אם אקסל רואה כאן מספר או טקסט, והנוסחה היא =ISNUMBER(A2) בכל שורה. אמת בשורה אחת ושקר בשורה אחרת, באותה עמודה, זו כבר התשובה.
השנייה שואלת מה האורך האמיתי של הערך, ונכתבת =LEN(A2) בהמשך. אורך גדול ממה שנראה על המסך אומר שיש בתוך התא תו נוסף.
השלישית שואלת מה קוד התו הראשון, כלומר =CODE(LEFT(A2,1)) והיא זו שמפרידה בין רווח רגיל, רווח בלתי שביר ואפס מוביל אמיתי.
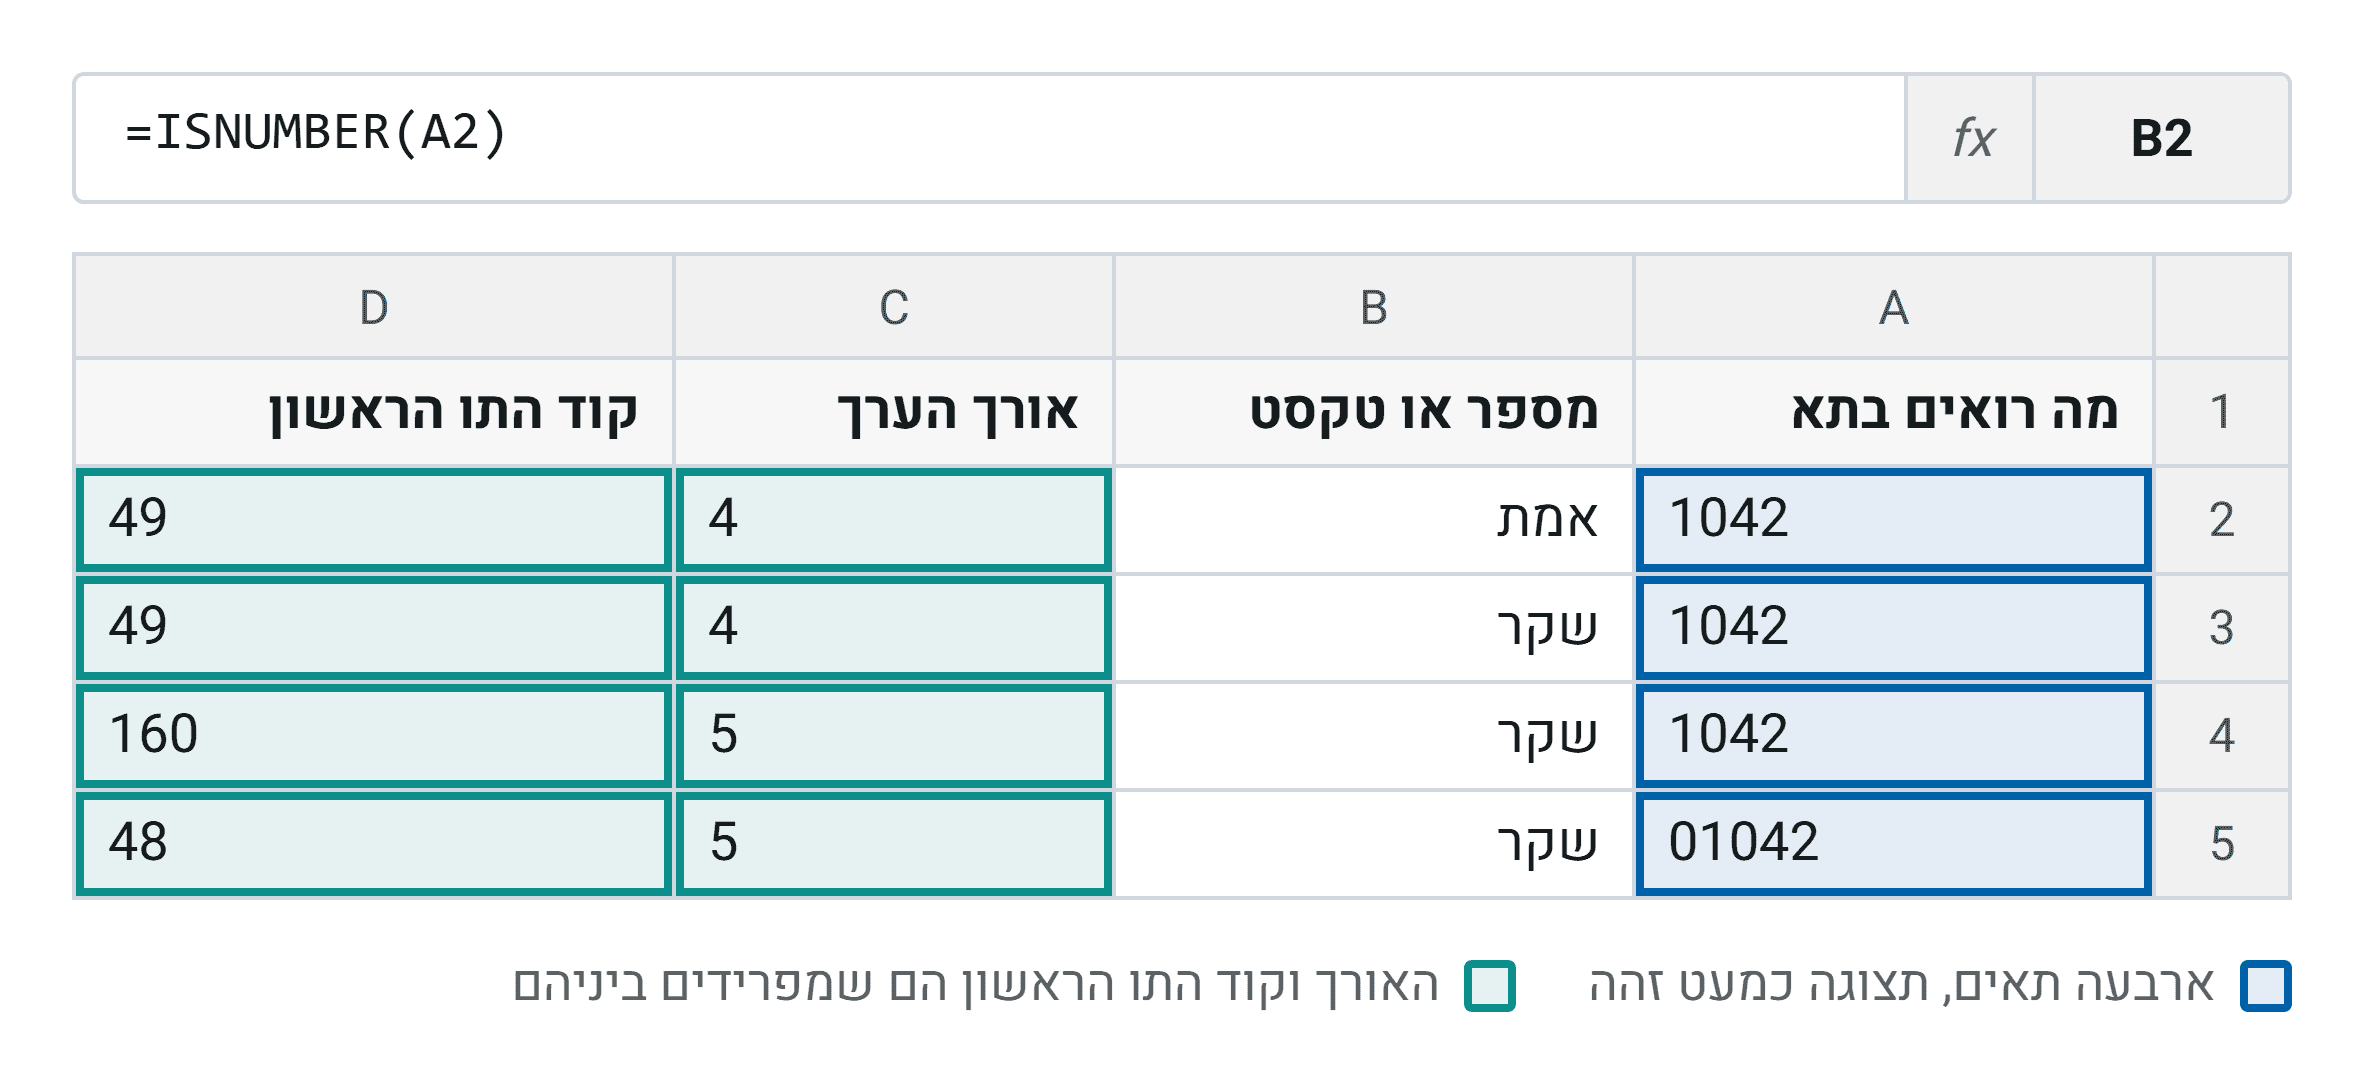
הריצו את שלושתן על שתי העמודות, זו שבדוח וזו שבטבלה. הבעיה נמצאת כמעט תמיד בצד שלא בדקתם.
המלכודת שגורמת לניקוי להיכשל
כאן נופלים אנשים שכבר עשו את הדבר הנכון. בתיעוד של הפונקציה שמסירה רווחים כתובה אזהרה מפורשת: היא תוכננה להסיר את תו הרווח שקודו 32, ובסט התווים קיים תו רווח נוסף, הרווח הבלתי שביר, שקודו 160, והיא אינה מסירה אותו בעצמה. התיעוד גם מציין שהתו הזה נפוץ בדפי אינטרנט.
כל קובץ שהודבק מדפדפן, או דוח שהופק כדף אינטרנט ונפתח באקסל, מגיע מלא בתו הזה. ניקיתם, בדקתם, והחיפוש עדיין נכשל. הנוסחה שמסירה את שניהם יחד היא =TRIM(SUBSTITUTE(CLEAN(A2),CHAR(160)," ")) והיא צריכה לרוץ לפני כל ניסיון המרה.
התיקון שרוב האנשים בוחרים, ולמה בקובץ פיננסי הוא שגוי
התשובה המיידית היא להמיר את העמודה למספרים. סימון העמודה, בדיקת השגיאות, המרה למספר, וזהו.
בקובץ פיננסי זו ברירת מחדל גרועה, ומשלוש סיבות.
אפסים מובילים. קוד סניף שנשמר כטקסט בשש ספרות מאבד את האפס שבתחילתו ברגע ההמרה, והוא אינו חוזר. אותו דבר במספר תיק, בקוד עובד ובכל מזהה שהאורך שלו הוא חלק מהמשמעות שלו.
ערכים מעורבים. עמודת מזהה אמיתית מכילה גם קודים שכוללים אותיות. באחת התשובות בפורום התמיכה של מיקרוסופט זה כתוב בדיוק כך: ניקוי והמרה של העמודה אינם פתרון אפשרי, מכיוון שהעמודה כוללת ערכים שחייבים להישמר כטקסט.
אורך הקוד. מיקרוסופט מתעדת שאקסל שומר חמש עשרה ספרות משמעותיות בלבד. קוד בן שש עשרה ספרות ומעלה אינו נשמר במלואו אחרי המרה, ושני קודים שנבדלים רק בספרות האחרונות הופכים לזהים. זו אינה שגיאה שתראו, זו התאמה שגויה שתקבלו.
והעיקר: המרה משנה את הנתונים לתמיד, ותיקון נוסחה אינו נוגע בהם בכלל.
התיקון שכן, נוסחה עיוורת לסוג
במקום להתאים את הנתונים לנוסחה, התאימו את הנוסחה לנתונים. מנסים את הערך כמו שהוא, ואם החיפוש נכשל מנסים אותו כטקסט, ואם נכשל שוב מנסים אותו כמספר.
המעבר לטקסט נעשה בשרשור מחרוזת ריקה לערך החיפוש, והמעבר למספר נעשה בפונקציה שממירה טקסט למספר. שימו לב שהיא מחזירה שגיאה כשהערך אינו מספר כלל, לכן כל ניסיון עטוף בפונקציה שתופסת שגיאה ומעבירה לניסיון הבא.
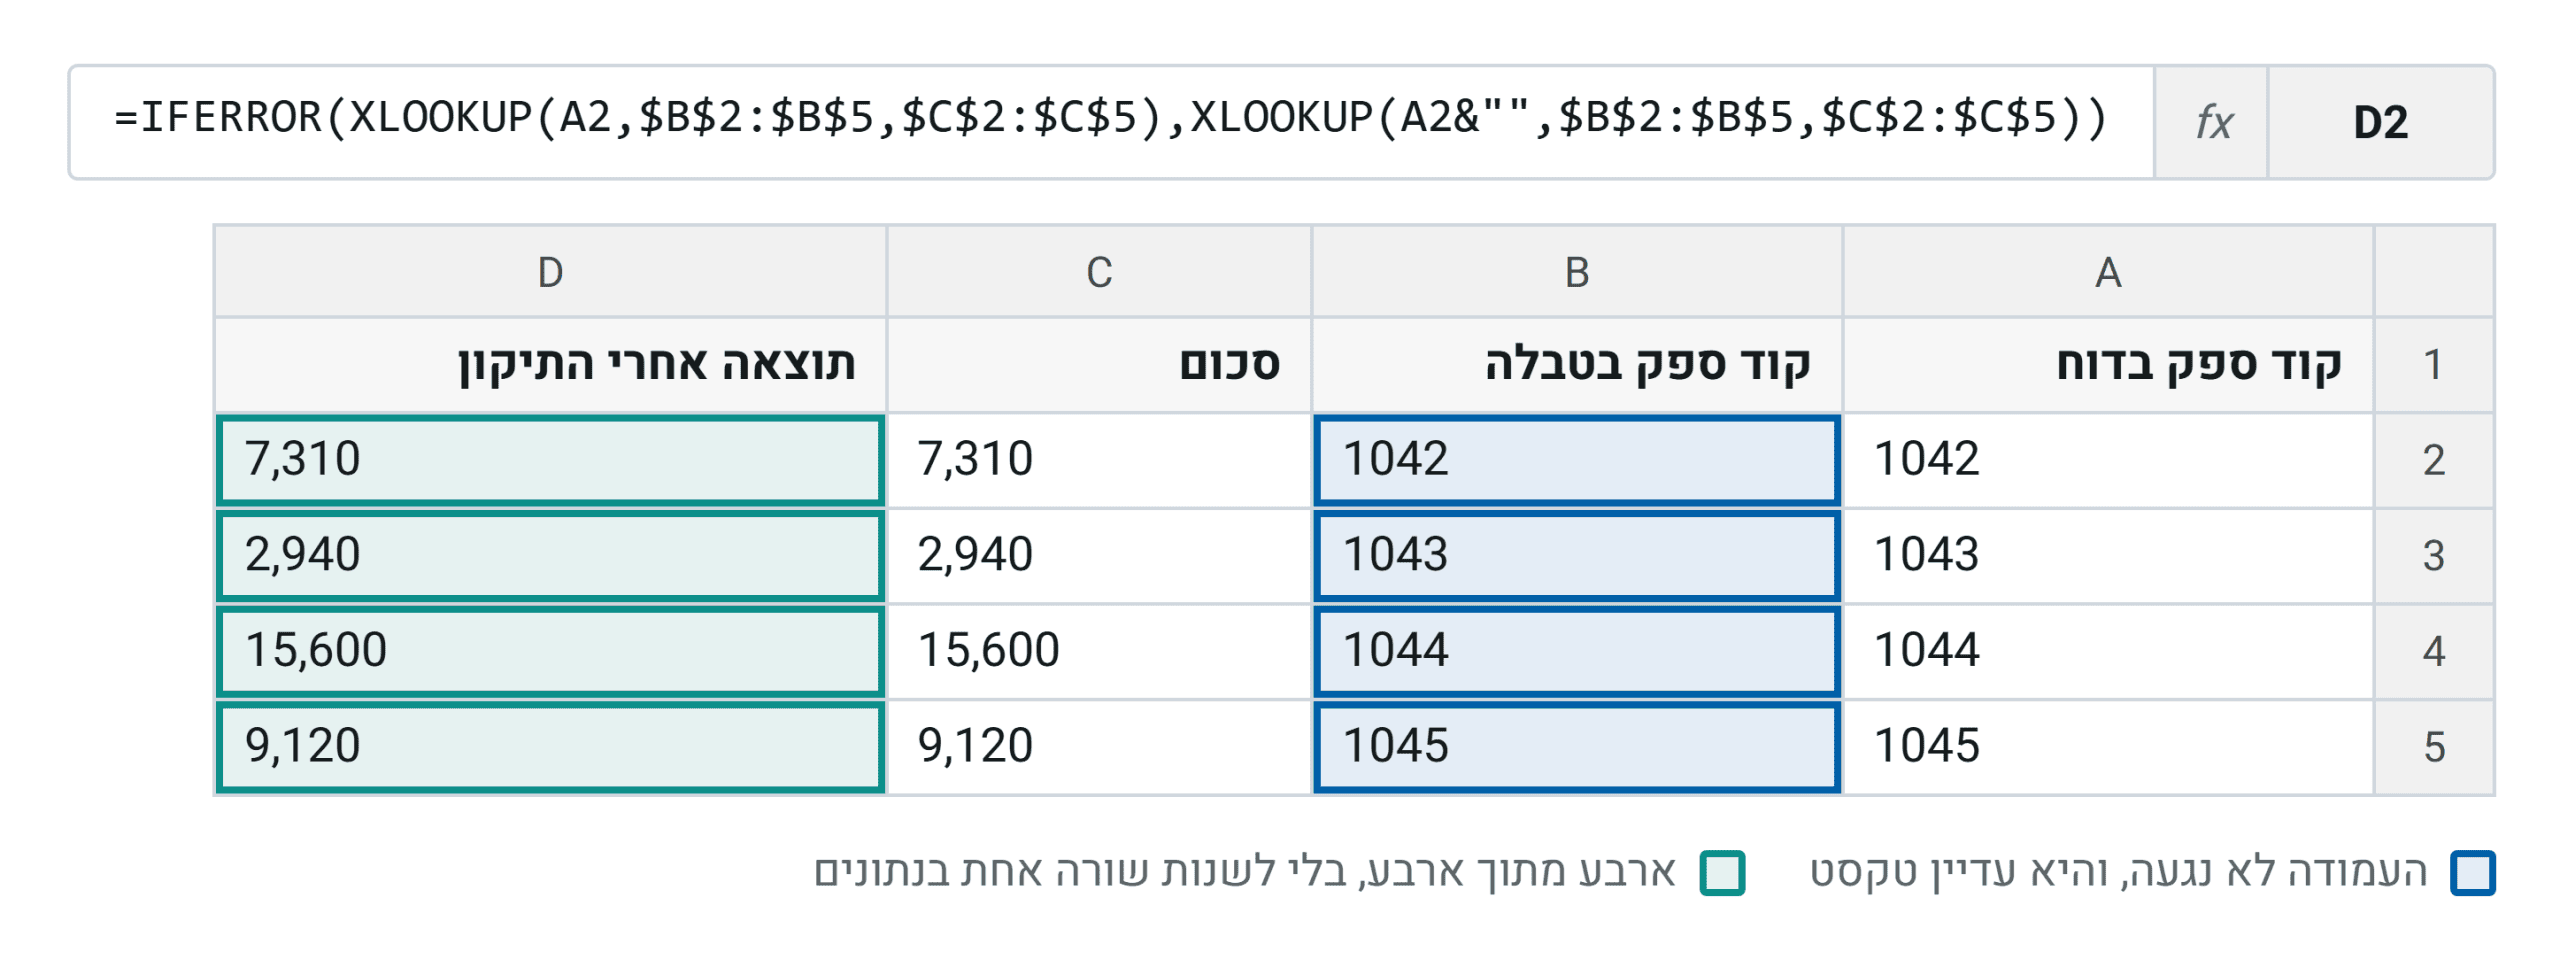
העמודה נשארת בדיוק כפי שהמערכת הוציאה אותה. רק הנוסחה השתנתה, ובחודש הבא, כשהקובץ יימשך מחדש, היא תמשיך לעבוד.
ומתי כן להמיר, ואיפה
יש מצב אחד שבו המרה היא התשובה הנכונה: ספרות בלבד, ממקור אחד, בלי אפסים מובילים ובלי אותיות. עמודת כמות, עמודת סכום, עמודת שנה.
גם אז, אם הקובץ נמשך מחדש בכל חודש, המרה ידנית שורדת עד המשיכה הבאה בלבד. המקום הנכון הוא שלב הטעינה.
רגע, מה זה בכלל שלב הטעינה. באקסל יש מנוע בשם Power Query שקורא את הקובץ לפני שהוא מגיע לגיליון, ומאפשר לקבוע שם מה קורה לכל עמודה. הכללים שנקבעים בו רצים מחדש בכל רענון, ולכן תיקון שנעשה שם נשאר.
שם קובעים את סוג העמודה במפורש, ומשאירים עמודת מזהה כטקסט בכל השורות. המנוע גם יודע לפרש טקסט לפי תרבות מוצהרת, כך שקובץ אמריקאי וקובץ אירופאי עם מפרידים שונים נקראים נכון בלי לשנות את הגדרות המחשב.
הכלל
נתונים שנראים זהים אינם בהכרח זהים, וההבדל אינו בעיצוב אלא בסוג הערך. לפני שמתקנים נוסחה ולפני שממירים עמודה, שואלים מה בדיוק מאוחסן בשני הצדדים. שלוש בדיקות, שלושים שניות.
וכלל שני, שקשה יותר לקבל. עמודת מזהה אינה עמודת מספרים. מספר חשבונית לא מחברים, לא מחסירים ולא מחשבים עליו ממוצע. הוא תווית, והמקום הבטוח לתווית הוא טקסט בכל השורות, בשני הקבצים.
והשאלה שנשארה פתוחה
נניח שהאבחון רץ, הנוסחה עיוורת לסוג, והקובץ מתחבר. עדיין נשארת השאלה הקשה יותר, וזו שהמאמר הזה לא עונה עליה: מי בארגון מחליט אם מספר ספק הוא מספר או תווית.
ההחלטה הזו אינה טכנית. היא נקבעת פעם אחת, כשמישהו מגדיר את המערכת, ומשם היא זולגת לכל קובץ שיוצא ממנה במשך שנים. רוב הארגונים שנכנסתי אליהם השנה לא ידעו להגיד מי קיבל אותה, ולכן כל חיבור בין שתי מערכות מתחיל מאבחון במקום מהגדרה.
את הדיון הזה אני מנהל בתוך מועדון The UNIQUE Way, ושם נמצאת גם ערכת האבחון המלאה: שלוש הבדיקות, ארבע נוסחאות מוכנות להעתקה, טבלת החלטה מתי להמיר ומתי לא, ונוסחת הניקוי שמסירה גם את הרווח הבלתי שביר. ההצטרפות חינם.